
jkim96/Muse-Glimmer-30B-DASHQ-INT3-g32
043
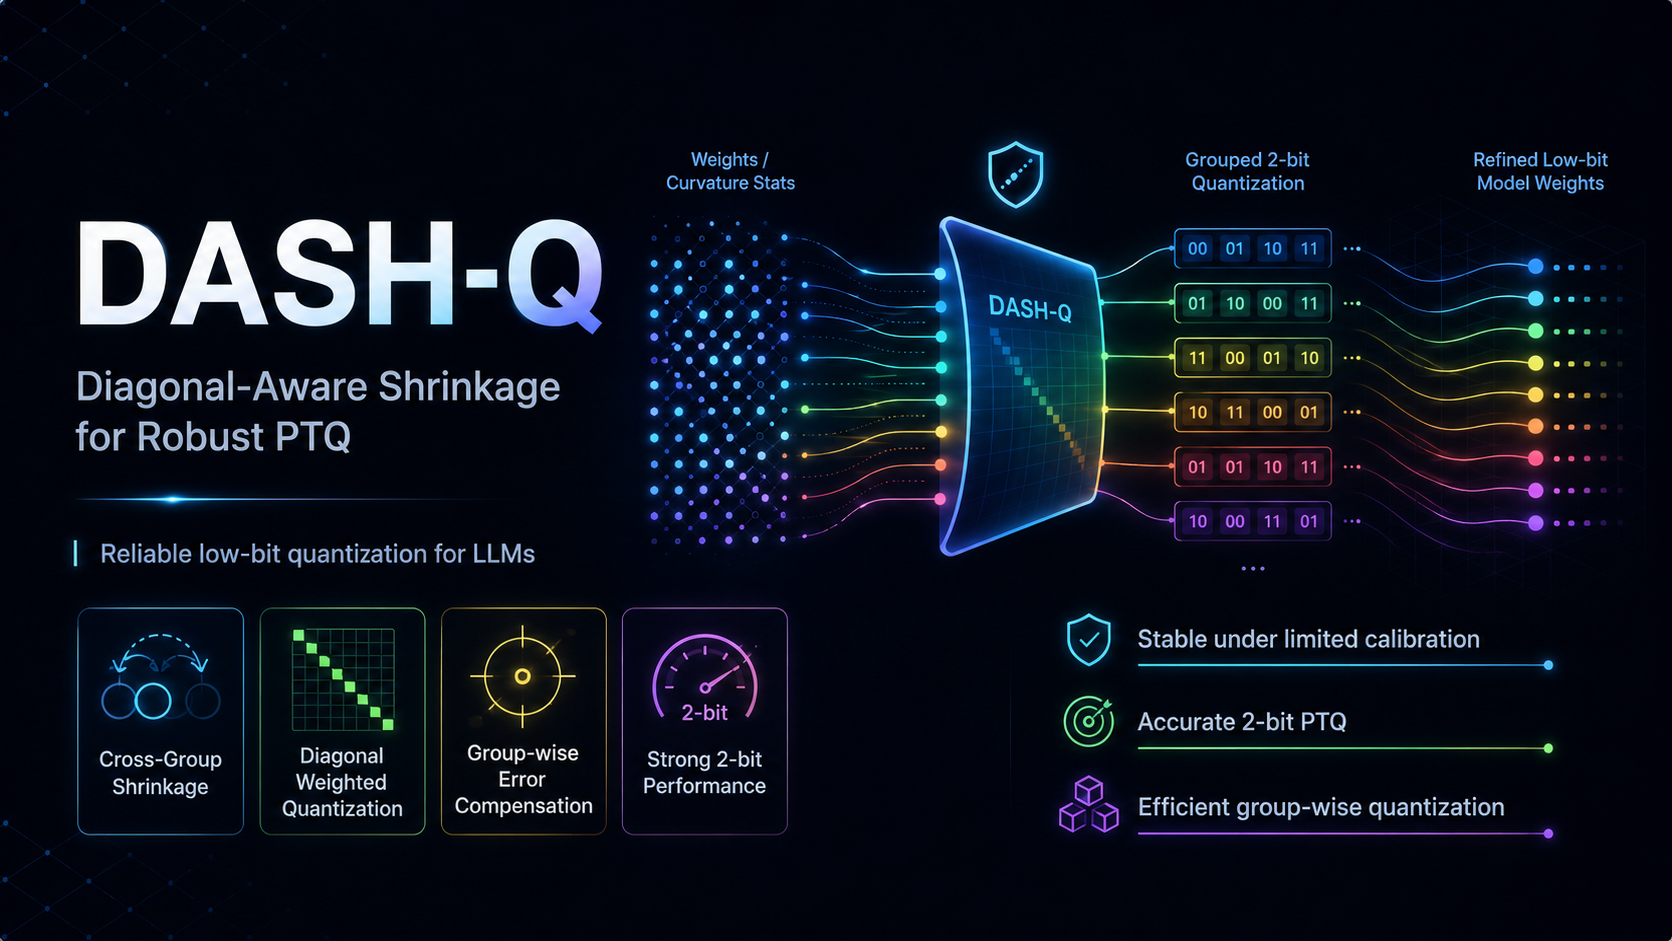
Muse-Glimmer-30B-DASHQ-INT3-g32
DASH-Q — Diagonal-Aware Shrinkage for Robust PTQ. INT3 · group size 32 · 22.4370 GB (from 59.5534 GB — 2.7x smaller)Usage
from transformers import AutoModelForImageTextToText, AutoTokenizer

model = AutoModelForImageTextToText.from_pretrained(
    "jkim96/Muse-Glimmer-30B-DASHQ-INT3-g32", trust_remote_code=True, device_map="cuda", dtype="auto"
)
tokenizer = AutoTokenizer.from_pretrained("jkim96/Muse-Glimmer-30B-DASHQ-INT3-g32")

messages = [{"role": "user", "content": "Explain 2-bit quantization in one sentence."}]
text = tokenizer.apply_chat_template(messages, add_generation_prompt=True, tokenize=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
print(tokenizer.decode(model.generate(**inputs, max_new_tokens=256)[0]))
trust_remote_code=True is required: the checkpoint ships its quantized-layer implementation (modeling_dashq.py) and Triton kernels (dashq_kernel.py). Without Triton, or on CPU, it falls back to dequantize-and-matmul in PyTorch.
Requirements
Quantization
Benchmarks
Full zero-shot / few-shot results for every DASH-Q checkpoint: [github.com/JaeminK/dashq#benchmarks](https://github.com/JaeminK/dashq#benchmarks)