
hotchpotch/japanese-reranker-xsmall-v2
6172k
hotchpotch/japanese-reranker-xsmall-v2
とても小さく速い日本語リランカーモデルシリーズ(v2)です。
リランカーについてや、技術レポート・評価等は以下を参考ください。
- とても小さく速く実用的な日本語リランカー japanese-reranker-tiny,xsmall v2 を公開
- 日本語最高性能のRerankerをリリース / そもそも Reranker とは?
- 日本語 Reranker 作成のテクニカルレポート
使い方
動作には transformers ライブラリの v4.48 以上が必要です。
pip install -U "transformers>=4.48.0" sentence-transformers sentencepieceGPU が Flash Attention 2 をサポートしている場合、flash-attn ライブラリを入れることで、高速な推論が可能です。
pip install flash-attn --no-build-isolationSentenceTransformers
from sentence_transformers import CrossEncoder
import torch

MODEL_NAME = "hotchpotch/japanese-reranker-xsmall-v2"

model = CrossEncoder(MODEL_NAME)
if model.device == "cuda" or model.device == "mps":
    model.model.half()
query = "感動的な映画について"
passages = [
    "深いテーマを持ちながらも、観る人の心を揺さぶる名作。登場人物の心情描写が秀逸で、ラストは涙なしでは見られない。",
    "重要なメッセージ性は評価できるが、暗い話が続くので気分が落ち込んでしまった。もう少し明るい要素があればよかった。",
    "どうにもリアリティに欠ける展開が気になった。もっと深みのある人間ドラマが見たかった。",
    "アクションシーンが楽しすぎる。見ていて飽きない。ストーリーはシンプルだが、それが逆に良い。",
]
scores = model.predict(
    [(query, passage) for passage in passages],
    show_progress_bar=True,
)
print("Scores:", scores)
SentenceTransformers + onnx の利用
CPU 環境や arm 環境などで、より高速に動かしたい場合は onnx や量子化モデルを利用できます。
pip install onnx onnxruntime accelerate optimumfrom sentence_transformers import CrossEncoder
# oxxn のモデルを選ばないと model.onnx が自動で使われる
# onnx_filename = None
# 量子化された最適なモデルを使う場合は、onnx_filename にファイル名を指定する
# onnx_filename = "onnx/model_qint8_avx2.onnx"
onnx_filename = "onnx/model_qint8_arm64.onnx"
if onnx_filename:
model = CrossEncoder(
MODEL_NAME,
device="cpu",
backend="onnx",
model_kwargs={"file_name": onnx_filename},
)
else:
model = CrossEncoder(MODEL_NAME, device="cpu", backend="onnx")
...HuggingFace transformers
from transformers import AutoTokenizer, AutoModelForSequenceClassification
from torch.nn import Sigmoid


def detect_device():
    if torch.cuda.is_available():
        return "cuda"
    elif hasattr(torch, "mps") and torch.mps.is_available():
        return "mps"
    return "cpu"


device = detect_device()
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
model = AutoModelForSequenceClassification.from_pretrained(MODEL_NAME)
model.to(device)
model.eval()

if device == "cuda":
    model.half()

query = "感動的な映画について"
passages = [
    "深いテーマを持ちながらも、観る人の心を揺さぶる名作。登場人物の心情描写が秀逸で、ラストは涙なしでは見られない。",
    "重要なメッセージ性は評価できるが、暗い話が続くので気分が落ち込んでしまった。もう少し明るい要素があればよかった。",
    "どうにもリアリティに欠ける展開が気になった。もっと深みのある人間ドラマが見たかった。",
    "アクションシーンが楽しすぎる。見ていて飽きない。ストーリーはシンプルだが、それが逆に良い。",
]
inputs = tokenizer(
    [(query, passage) for passage in passages],
    padding=True,
    truncation=True,
    max_length=512,
    return_tensors="pt",
)
inputs = {k: v.to(device) for k, v in inputs.items()}
logits = model(**inputs).logits
activation = Sigmoid()
scores = activation(logits).squeeze().tolist()

print("Scores:", scores)
小型リランカーの特徴
japanese-reranker-tiny-v2、japanese-reranker-xsmall-v2、japanese-reranker-small-v2、japanese-reranker-base-v2は、以下の特徴を持つ小型リランカーモデルです:
- CPUやAppleシリコン環境でも実用的な速度で動作
- 高価なGPUリソースなしでもRAGシステムの精度向上が可能
- エッジデバイスでの展開や低レイテンシが要求される本番環境で活用可能
- ModernBertベースのruri-v3-pt-30m(tiny/xsmall)、ruri-v3-pt-70m(small)、ruri-v3-pt-130m(base)を利用
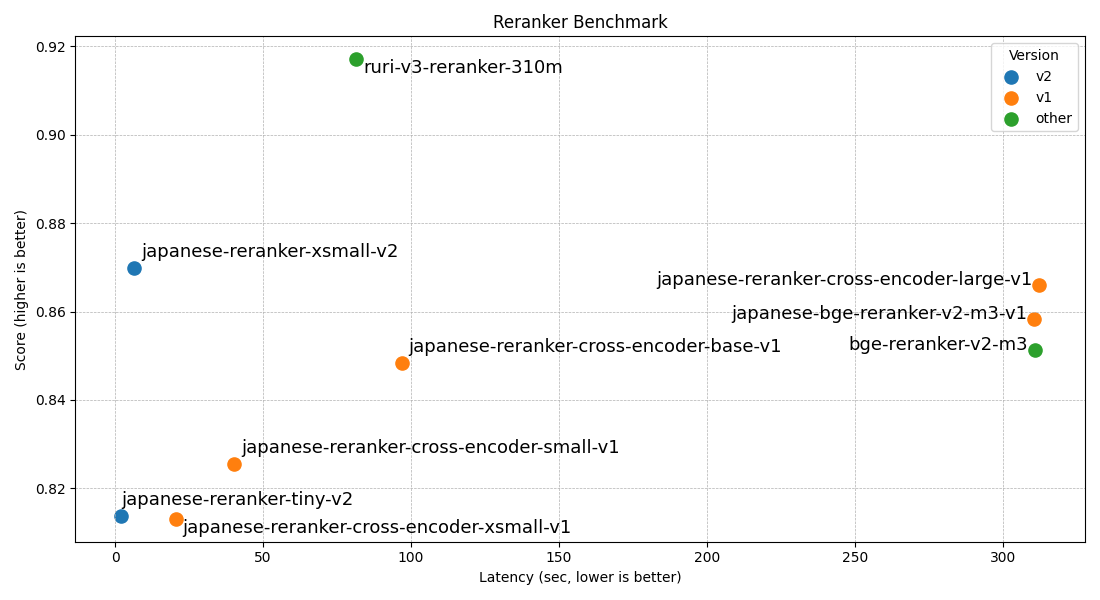
評価結果
推論速度
以下は約15万ペアをリランキングした際の推論速度結果(トークナイズ時間を除く純粋なモデル推論時間)です。MPS(Appleシリコン)とCPU測定にはM4 Max、GPUにはRTX5090を使用しています。GPU処理では flash-attention2 を使用しています。
推論速度のベンチマークに用いたスクリプトはこちらです。
ライセンス
MIT License
学習データセット
主な学習データセットは hotchpotch/japanese-reranker-v2-hard-negatives です。