
Bingsu/laion2B-multi-korean-subset
laion2B-multi-korean-subset About dataset a subset data of laion/laion2B-multi, including only korean Lisence CC-BY-4.0 Data Structure Data Instance >>> from datasets import load_dataset >>> dataset = load_dataset("Bingsu/laion2B-multi-korean-subset") >>> dataset DatasetDict({ train: Dataset({ features: ['SAMPLE_ID', 'URL', 'TEXT', 'HEIGHT', 'WIDTH', 'LICENSE', 'LANGUAGE', 'NSFW', 'similarity']… See the full description on the dataset page: https://huggingface.co/datasets/Bingsu/laion2B-multi-korean-subset.
laion2B-multi-korean-subset
Dataset Description
- Homepage: laion-5b
- Huggingface: laion/laion2B-multi
About dataset
a subset data of laion/laion2B-multi, including only korean
Lisence
CC-BY-4.0
Data Structure
Data Instance
>>> from datasets import load_dataset
>>> dataset = load_dataset("Bingsu/laion2B-multi-korean-subset")
>>> dataset
DatasetDict({
    train: Dataset({
        features: ['SAMPLE_ID', 'URL', 'TEXT', 'HEIGHT', 'WIDTH', 'LICENSE', 'LANGUAGE', 'NSFW', 'similarity'],
        num_rows: 11376263
    })
})>>> dataset["train"].features
{'SAMPLE_ID': Value(dtype='int64', id=None),
'URL': Value(dtype='string', id=None),
'TEXT': Value(dtype='string', id=None),
'HEIGHT': Value(dtype='int32', id=None),
'WIDTH': Value(dtype='int32', id=None),
'LICENSE': Value(dtype='string', id=None),
'LANGUAGE': Value(dtype='string', id=None),
'NSFW': Value(dtype='string', id=None),
'similarity': Value(dtype='float32', id=None)}Data Size
download: 1.56 GiB<br> generated: 2.37 GiB<br> total: 3.93 GiB
Data Field
- 'SAMPLE_ID':
int - 'URL':
string - 'TEXT':
string - 'HEIGHT':
int - 'WIDTH':
int - 'LICENSE':
string - 'LANGUAGE':
string - 'NSFW':
string - 'similarity':
float
Data Splits
Note
Height, Width
이미지의 가로가 HEIGHT로, 세로가 WIDTH로 되어있는 것 같습니다.
>>> dataset["train"][98]
{'SAMPLE_ID': 2937471001780,
 'URL': 'https://image.ajunews.com/content/image/2019/04/12/20190412175643597949.png',
 'TEXT': '인천시교육청, 인천 시군구발전협의회  임원진과의 간담회 개최',
 'HEIGHT': 640,
 'WIDTH': 321,
 'LICENSE': '?',
 'LANGUAGE': 'ko',
 'NSFW': 'UNLIKELY',
 'similarity': 0.33347243070602417}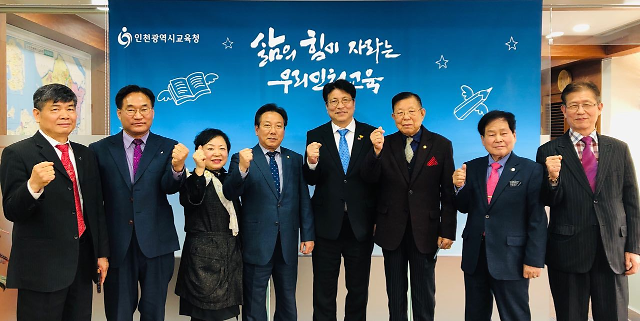
csv file, pandas
# pip install zstandard
import pandas as pd
from huggingface_hub import hf_hub_url

url = hf_hub_url("Bingsu/laion2B-multi-korean-subset", filename="laion2B-multi-korean-subset.csv.zst", repo_type="dataset")
# url = "https://huggingface.co/datasets/Bingsu/laion2B-multi-korean-subset/resolve/main/laion2B-multi-korean-subset.csv.zst"
df = pd.read_csv(url)
<https://huggingface.co/datasets/Bingsu/laion2B-multi-korean-subset/resolve/main/laion2B-multi-korean-subset.csv.zst>
778 MB
Code used to generate
import csv
import re

from datasets import load_dataset
from tqdm import tqdm


pattern = re.compile(r"[가-힣]")


def quote(s: str) -> str:
    s = s.replace('"""', "")
    return s


def filter_func(example) -> bool:
    lang = example.get("LANGUAGE")
    text = example.get("TEXT")
    if not isinstance(lang, str) or not isinstance(text, str):
        return False
    return lang == "ko" or pattern.search(text) is not None


file = open("./laion2B-mulit_korean_subset.csv", "w", encoding="utf-8", newline="")

ds = load_dataset("laion/laion2B-multi", split="train", streaming=True)
dsf = ds.filter(filter_func)
header = [
    "SAMPLE_ID",
    "URL",
    "TEXT",
    "HEIGHT",
    "WIDTH",
    "LICENSE",
    "LANGUAGE",
    "NSFW",
    "similarity",
]
writer = csv.DictWriter(file, fieldnames=header)
writer.writeheader()

try:
    for data in tqdm(dsf):  # total=11378843
        data["TEXT"] = quote(data.get("TEXT", ""))
        if data["TEXT"]:
            writer.writerow(data)
finally:
    file.close()

print("Done!")
실행에 약 8시간이 소요되었습니다. 이후에 HEIGHT나 WIDTH가 None인 데이터를 제거하고 업로드하였습니다.
img2dataset
img2dataset을 사용하여 URL로된 이미지들을 데이터셋 형태로 만들 수 있습니다.